Blog · Retours terrain
Utiliser l'IA sur ses dossiers clients sans que rien ne sorte du cabinet
Il y a quelques jours, j’ai échangé avec le dirigeant d’un cabinet de conseil juridique. Il veut moderniser son activité, et l’IA l’intéresse. Mais une question le bloque : comment s’en servir sur ses dossiers sans exposer ses clients ?
Aujourd’hui, avant de soumettre un document à ChatGPT ou à un autre assistant, son équipe caviarde à la main les noms, les adresses et les références. C’est long et fastidieux, et il suffit d’un oubli pour qu’un nom parte là où il ne devrait pas. Résultat : l’IA reste un gadget qu’on utilise du bout des doigts, alors que le cabinet a des années d’archives (plusieurs téraoctets de PDF et de scans) qui pourraient enfin devenir exploitables.
Sa question est excellente, et elle concerne bien plus que les juristes : experts-comptables, cabinets RH, professions de santé, agences immobilières… Toutes les structures qui manipulent des informations confidentielles se la posent. Voici les pistes que je lui ai présentées.
La bonne question : où tourne le moteur ?
On présente souvent le sujet comme un choix binaire : « soit on utilise l’IA et on prend des risques, soit on s’en passe ». En réalité, la vraie question est plus simple : où tourne le moteur d’IA, et donc où transitent les données ?
Quelle que soit la réponse, la mécanique est la même :
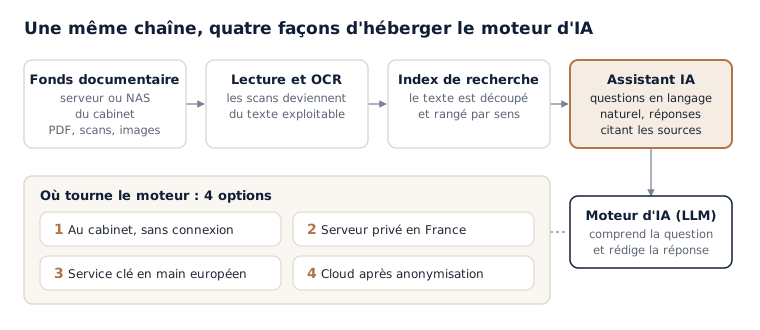
- Le fonds documentaire : les fichiers du cabinet, sur un serveur de stockage (un NAS) ou dans le cloud.
- La lecture et l’OCR : les documents sont convertis en texte exploitable.
- L’index de recherche : le texte est découpé et rangé par sens, pour retrouver rapidement les passages pertinents.
- L’assistant : l’équipe pose ses questions en langage naturel, et l’assistant répond en citant ses sources.
Derrière l’assistant, un modèle de langage (le « LLM ») comprend la question et rédige la réponse. C’est lui qu’on peut placer à différents endroits.
L’OCR, c’est quoi ? La reconnaissance optique de caractères « lit » le texte d’une image. Pour un ordinateur, un document scanné n’est qu’une photo : impossible d’y chercher un mot. L’OCR le transforme en vrai texte. Cette étape peut tourner entièrement en interne, avec des outils open source, sans rien envoyer à l’extérieur. Sa qualité dépend de celle des scans : un document net donne un texte quasi parfait, un scan flou ou une note manuscrite beaucoup moins.
Une remarque rassurante sur le volume : plusieurs téraoctets de fichiers ne font pas plusieurs téraoctets de texte. Les scans pèsent lourd parce que ce sont des images. Une fois convertis, ils tiennent souvent en quelques dizaines de gigaoctets. C’est ce volume-là que l’IA manipule.
Quatre façons de faire
1. Tout en local, au cabinet
Une machine dédiée, installée au bureau, fait tourner un modèle d’IA ouvert (Mistral, Qwen, Llama…). Un Mac Studio bien doté en mémoire fait très bien l’affaire pour une petite équipe. Aucune connexion vers l’extérieur n’est nécessaire.
C’est la solution la plus rassurante : rien ne quitte le bureau, et le caviardage devient inutile. En contrepartie, les modèles qu’on fait tourner chez soi sont un cran en dessous des meilleurs modèles du marché, et l’indexation initiale d’un gros fonds peut prendre plusieurs jours de calcul.
2. Un serveur privé chez un hébergeur français
Même principe, mais la machine est louée chez un hébergeur français (OVHcloud, Scaleway…) et accessible uniquement depuis le cabinet, par une connexion sécurisée. On gagne en puissance et on n’a pas de matériel à gérer. Les données sortent des murs, mais restent en France, chiffrées, sous droit européen. Le coût mensuel est nettement plus élevé.
3. Un service clé en main européen
Un assistant professionnel prêt à l’emploi, par exemple Le Chat de Mistral, une société française, dans son offre pour les équipes. Rien à installer, une excellente qualité de réponse, et un engagement contractuel de non-réutilisation des données.
Les documents sont tout de même traités chez le prestataire. Pour des informations soumises au secret, cela mérite une analyse sérieuse. Et importer des années d’archives dans ce type de service n’est pas vraiment prévu.
4. L’hybride : anonymiser automatiquement, puis utiliser le cloud
C’est l’option que je trouve la plus astucieuse. Une petite machine au cabinet remplace automatiquement les noms, adresses et références par des étiquettes (« CLIENT_1 », « SOCIÉTÉ_A ») avant tout envoi. L’IA dans le cloud ne voit que du texte pseudonymisé, et la réponse est ré-identifiée en local.
On garde la qualité des meilleurs modèles et on supprime le caviardage manuel. Seule limite : aucune détection automatique n’est parfaite à 100 %. Sur les dossiers les plus sensibles, un contrôle humain reste utile.
Et l’outil pour poser ses questions ?
C’est souvent la première inquiétude : « il va falloir développer un logiciel ? » Non, du moins pas pour commencer.
Des outils open source gratuits et éprouvés, comme Open WebUI ou AnythingLLM, font déjà ce travail. Pour l’équipe, cela ressemble à ChatGPT : une fenêtre de discussion dans le navigateur, un compte par personne. On pose sa question, l’outil cherche dans les documents du cabinet et la réponse indique d’où vient l’information. On peut aussi créer des espaces séparés, par client ou par domaine, avec des droits d’accès différents.
Avec un service clé en main, l’interface est fournie. Le développement sur mesure ne se justifie qu’une fois les usages validés, par exemple pour se brancher sur le logiciel métier ou générer des documents à partir de modèles.
Combien ça coûte ?
Quelques ordres de grandeur pour une petite équipe, relevés en octobre 2026 :
| Option | Achat de matériel | Coût mensuel | Les données sortent du cabinet ? |
|---|---|---|---|
| Tout en local | 6 000 à 8 000 € | 20 à 50 € | Non |
| Serveur privé français | Aucun | 450 à 1 400 € | Oui, chez un hébergeur français |
| Service clé en main | Aucun | environ 25 $ par utilisateur | Oui, chez un prestataire européen |
| Hybride | 1 500 à 2 500 € | 50 à 200 € | Uniquement du texte pseudonymisé |
Ces montants couvrent le matériel, l’hébergement et les abonnements. Ils n’incluent pas le temps d’accompagnement : installation, paramétrage, reprise des documents, formation de l’équipe, puis suivi. C’est souvent le poste qui fait la différence entre un outil adopté et un outil abandonné au bout de trois semaines.
Le RGPD, sans jargon
La technique ne fait pas tout : quelle que soit l’option choisie, le cadre juridique suit. Voici les points que je vois le plus souvent mal compris.
Pseudonymiser n’est pas anonymiser. Remplacer « Dupont » par « CLIENT_1 » réduit fortement le risque, mais le cabinet garde la table de correspondance. Pour lui, ces données restent des données personnelles, soumises au RGPD, comme le rappelle la CNIL. La pseudonymisation est une très bonne mesure de sécurité, pas une sortie du cadre.
Le fournisseur d’IA est un sous-traitant. Dès qu’un prestataire traite des données pour le compte du cabinet (hébergeur, service d’IA), il faut un contrat qui encadre ce traitement : ce que le prestataire a le droit de faire, où sont stockées les données, combien de temps, qui y accède. C’est ce que prévoit l’article 28 du RGPD, détaillé par la CNIL.
Les données qui quittent l’Union européenne. C’est la vraie différence entre un fournisseur américain et un fournisseur européen. Un prestataire soumis au droit américain peut être contraint de communiquer des données à ses autorités, même si elles sont stockées en Europe. Pour des données confidentielles, c’est un critère de choix à part entière, et c’est ce qui rend les options locale et souveraine intéressantes.
Le registre et l’analyse d’impact. Un nouveau traitement s’inscrit dans le registre du cabinet. Et une analyse d’impact (l’AIPD) devient obligatoire lorsqu’un traitement remplit au moins deux des neuf critères de risque listés par la CNIL. Parmi eux : les données sensibles ou très personnelles, le traitement à grande échelle, ou l’usage d’une technologie nouvelle. Un fonds juridique interrogé par une IA peut vite cocher deux cases.
Le secret professionnel s’ajoute au RGPD. Le RGPD protège les personnes ; le secret professionnel et les engagements de confidentialité protègent la relation avec le client. Être conforme au premier ne suffit pas toujours à respecter les seconds.
Dernier point : depuis février 2025, le règlement européen sur l’IA demande aux entreprises qui utilisent des systèmes d’IA de veiller à ce que leurs équipes soient suffisamment formées à ces outils (article 4). Une bonne raison de ne pas faire l’impasse sur la formation.
Par où commencer ?
Mon conseil : ne pas tout acheter d’un coup. Je recommande plutôt un pilote de quelques semaines :
- Choisir un échantillon représentatif : un type de dossier, avec des PDF et des scans.
- Tester un modèle local et l’anonymisation automatique sur de vrais documents.
- Mesurer avec l’équipe : pertinence des réponses, temps gagné, rapidité.
- Décider de l’architecture cible sur des faits, pas sur des promesses commerciales.
Si la qualité en local suffit, la question de la confidentialité est réglée pour de bon. Sinon, l’approche hybride offre souvent le meilleur compromis.
L’IA n’oblige pas à choisir entre efficacité et confidentialité. Elle oblige surtout à se poser la bonne question au bon moment, avant d’envoyer le premier document.
Sources
RGPD et réglementation
- CNIL, Identifier les données personnelles (pseudonymisation et anonymisation)
- CNIL, Responsable de traitement et sous-traitant : 6 bonnes pratiques (contrat de sous-traitance, article 28 du RGPD)
- CNIL, Ce qu’il faut savoir sur l’analyse d’impact relative à la protection des données (AIPD) (les neuf critères de l’AIPD)
- CNPD Luxembourg, La maîtrise de l’IA (article 4 du règlement sur l’IA)
Outils cités
Prix (relevés en octobre 2026)
- Mac Studio M4 Max 128 Go : fiche revendeur
- Serveur GPU L40S chez OVHcloud : comparatif ComputePrices
- Offres Le Chat de Mistral : comparatif CostBench